GitHub hosts HunyuanVideo, Tencent's open-source framework for large-scale video generation models, enabling AI-driven video creation.
Gradian
FreeStarting price
0Popularity
About Gradian
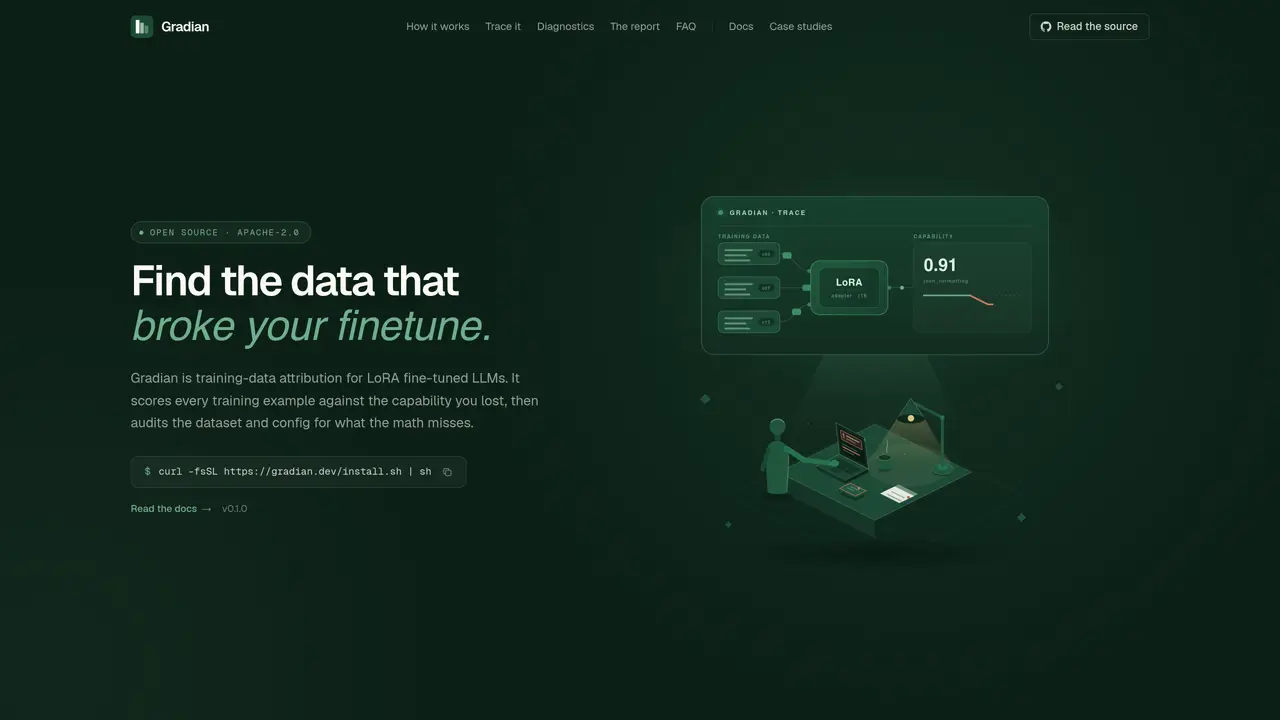
Gradian provides training-data attribution for LoRA fine-tuned large language models. It evaluates fine-tune runs to measure regressed capabilities, attributes influence to specific training examples, and audits datasets and configurations for faults that mathematical attribution may miss. The tool generates a single report that identifies clusters of problematic examples, mechanical causes, and actionable fixes before retraining. It supports contrastive queries comparing desired and actual outputs, influence functions over LoRA adapter gradients, and deterministic diagnostics across datasets, hyperparameters, and training dynamics. Gradian operates locally without GPU for diagnostics and uses a single GPU for attribution, with no telemetry or data exfiltration. It reads normalized run artifacts from common training stacks and caches gradient indices for efficient reuse.
Key features
- Measures regressed capabilities using influence functions over LoRA gradients
- Attributes influence to specific training examples and groups them into clusters
- Runs deterministic diagnostics across dataset, config, and training dynamics
- Supports contrastive queries for output comparisons
- Generates actionable reports with mechanical causes and fixes
- Caches gradient indices for efficient reuse on subsequent queries
- Includes counterfactual mode and tail-patch checks for validation
- Provides Apache-2.0 licensed open-source tool
Use cases
- Identifying training examples that degrade specific model capabilities
- Diagnosing dataset or configuration issues causing fine-tune regressions
- Validating fixes by retraining after removing attributed examples
Pros
- Ranks training examples by negative influence on fine-tune capabilities
- Provides deterministic diagnostics for dataset, config, and training dynamics
- Supports contrastive queries to compare desired and actual model outputs
- Operates locally with no telemetry or data exfiltration
- Compatible with common training stacks via normalized run artifacts
Cons
- Requires PEFT LoRA adapter on HuggingFace causal models
- Attribution requires GPU with minimum 24GB VRAM for 1B models
- No cloud or multi-user support indicated
- Limited to LoRA fine-tuned LLMs
Frequently asked questions about Gradian
What does Gradian actually do?
Gradian ranks training examples by their negative influence on a capability that a LoRA fine-tuned model lost, then groups them into clusters for inspection. It produces a single report identifying the problematic data clusters, mechanical causes, and actionable fixes before retraining.
Who is Gradian for?
Gradian is designed for teams fine-tuning large language models with LoRA adapters who need to diagnose regressed capabilities and audit datasets or configurations for faults that mathematical attribution may miss.
How does Gradian decide which examples are to blame?
Gradian uses influence functions over the gradients of the LoRA adapter, with a default engine that approximates inverse curvature in closed form. It employs contrastive queries comparing desired and actual outputs to identify responsible examples.
How do I know the result is not noise?
Gradian applies a bootstrap significance gate using 2000 resamples and a 95% confidence interval before treating a result as a diagnosis. It also includes a counterfactual mode and a faster tail-patch check to validate findings by retraining or taking a single gradient step.
What if the problem is my config, not my data?
Gradian includes a deterministic audit that checks datasets, hyperparameters, and training dynamics for issues like truncated completions, loss masks covering prompts, or learning rate misconfigurations. The audit runs on CPU and completes in seconds.
Does it work with my training stack?
Gradian is trainer-agnostic and reads normalized run artifacts, so it supports fine-tunes from stacks like trl, unsloth, axolotl, or custom scripts. Attribution requires a PEFT LoRA adapter on HuggingFace causal models.